Пять нейросетей строили мой PDF-сервис. Осталась одна
Осенью 2025-го я завёл аккаунт в Qwen и поставил её родной CLI себе на комп. Свободного времени было много, а идей ноль. У нейросети тогда были, по сути, бесплатные лимиты: генерируй сколько хочешь, никто не резал ни токены, ни запросы. Грех было не начать строить. Тем более строить было нечего.
Тут, уважаемые читатели, надо объяснить положение вещей. Идей у меня не было. Совсем. Я перебирал варианты с той тоской, с какой голодный человек четвёртый час смотрит в холодильник: там есть всё, кроме еды. Калькуляторы, конвертеры валют, виджеты всякие. Это всё уже сделано. Сто раз. Причём дважды. А делать двадцатый конвертер валют — это как открыть ларёк рядом с «Пятёрочкой»: покупатели рядом, а всё равно ты ларёк.
PDF-конвертеры — ниша не то чтобы денежная. Кто в ней сидит, тот знает. Мне просто хотелось слепить что-то своё. Не знаю, как объяснить. Хотелось, и всё.
Повод был бытовой. Был период, когда я работал с PDF плотно и был завсегдатаем ilovepdf. С тем самым лицом, с каким заходишь в аптеку в двадцать три сорок: виновато и молча. Подписать, дописать, отправить в банк, отправить на работу. И каждый раз танцы с файлами.
И тут закралась мысль: а чё, если сделать свой?
Дальше было самое полезное. Отдал Qwen на телефоне задачу на глубокое исследование: посмотреть рынок именно PDF-конвертеров, насколько сложно такое сделать и на чём написаны конкуренты. Вопрос был простой: реально это сделать вдвоём с нейросетью или мы оба погибнем смертью храбрых?
Реально. Начал с питона и готовых библиотек. Писать с нуля — долго и геморройно, а геморрой, в отличие от токенов, лимитами не ограничен. Qwen перебирала GitHub и находила то, что умные люди сделали до нас, а я складывал это в кучу: pypdf — склеить, разрезать, повернуть; pikepdf — вытащить и пережать; PyMuPDF — рендер и текстовый слой; pdf2image с poppler — картинки из страниц; pdf2docx — конвертация в Word; pytesseract — распознавание; reportlab — водяные знаки. Сверху Flask, celery и redis, чтобы тяжёлое не блокировало лёгкое. Лёгкое всегда виновато первым.
Сервер снял самый дешёвый на Beget: два ядра, четыре гигабайта оперативки, шестьдесят гигов диска. Мне тогда казалось, что это космос. Через полгода мне казалось, что это телефон.
Вообще я в этом ничего не понимал. Просто повторял за нейросетью, а когда не получалось — злился и шёл пить чай. Иногда помогало.
Qwen накидала базу: фронтенд, внешний облик. Выглядело так, будто страницу собирали из запчастей, найденных на обочине: всё работает, но смотреть больно. Я не расстроился. Мне нужен был функционал, а не красота. Красоту, думал, приделаю потом.
Дальше сайт стал обрастать мясом и жиром, без всякого плана. Сначала конвертация. Потом ротация. Потом слияние. Потом разделение. И по накатанной: водяной знак, пароль, распознавание, сравнение. Каждая функция была на один вечер. Только вечера эти шли месяцами, и заканчивались одинаково: то тут правка, то там баг, а иногда и оба, причём в одном месте.
А потом у Qwen появились лимиты. До миллиона токенов, и всё, дальше режь. Qwen отлетала. Начался «апокалипсис по расписанию»: сидишь такой, весь в планах, а тебе говорят, что лимит кончился. Как людям в девяносто втором говорили, что деньги кончились.
Вот тут я первый раз задумался о подписке. До этого я никогда в жизни не платил за нейросети и свято верил, что бесплатно будет всегда. Как верили все, кто потом покупал доллары по двести.
Minimax 2.7, десять долларов. Первая платная модель в моей жизни. Я заплатил и почувствовал себя инвестором. Через неделю почувствовал себя человеком, который вложился в пони, запряжённого в асфальтовый каток: возница серьёзный, каток настоящий, а пони если что и сдвинет, то только с места, на котором стояла.
Проект к тому моменту весил три с половиной гигабайта, в нём были тысячи строк, и Minimax на этом масштабе предсказуемо плыл. Галлюцинировал, терял контекст и выдумывал функции, которых нет, причём с уверенностью нотариуса, заверяющего липовую доверенность. Есть поговорка: скупой платит дважды. С Minimax я понял, что тупой платит трижды, а русский программист — до скончания лимитов.
ChatGPT Business. Купил по совету из ютуба, на площадке, где торгуют аккаунтами. Двое нищих умников, то есть я и нейросеть, тащили проект вдвоём: один пишет код, второй скармливает первому результат на валидацию, и оба уверены, что инструмент держит именно собеседник. Дело пошло веселее, затащили катку.
А потом на такие аккаунты взлетели цены: с трёхсот рублей до полутора тысяч за две недели. Экономика, как ей и положено, диктовала: нейросеть дорожала быстрее, чем я успевал задать ей вопрос.
GLM. Тут надо отдать должное, не всё же в этой жизни ругать: классная модель. Поправила кучу того, что до неё было наляпано на бэкенде. Но мы упирались в лимиты, а у неё пятичасовое ожидание. Пять часов смотреть в стену, когда в голове уже готово следующее изменение, — отдельный вид извращения, и я к нему был не готов. Как свидание с собственным нетерпением. Оно настроено серьёзно, а ты нет.
DeepSeek v4 Pro. Тогда он стоил копейки. Я полез искать, как пополнять, купил зарубежную виртуальную карту, и с тех пор мы вместе. Проект он ведёт по сей день. Тот DeepSeek и нынешний — разные люди. Фамилия одна.
Пока эта карусель крутилась, шла вторая работа, которую никто не видит. Дни на бэкенд: чтобы не было ошибок, чтобы гонять тесты, чтобы разворачиваться на любом сервере за вечер. Сервер, кстати, пришлось менять.
Beget подорожал так, что платить стало не по силам. Переехал за те же деньги на шесть ядер, двенадцать гигабайт памяти и SSD в разы толще. Сервер не подводит который месяц.
Чтобы не зависеть от одного хостера, я всё упаковал в Docker и настроил перенос так, чтобы при падении или очередном подорожании развернуться на новом месте без потерь. Работа скучная, её никто не видит и о ней не пишут. Как менять прокладку в кране: по видео пять минут, по жизни выходной и сорванная резьба, но без неё воды в доме нет.
Что в итоге. Восемнадцать инструментов: сжать, конвертировать в Word и Excel, объединить, разделить, повернуть, поставить водяной знак, закрыть паролем, снять пароль, распознать текст, сравнить два файла, починить битый. Редактор прямо в браузере на wasm, написанный на Rust, файл для правки никуда не уходит. Офисные документы считает gotenberg с LibreOffice, сжатие qpdf и ghostscript. Тот самый стек из начала, только обросший мясом, жиром и парой седых волос.
И честно про результат. Людей мало: по логам около двадцати шести человек в сутки. В Google за три месяца семьсот тридцать два показа и три клика. Три. Я сначала думал, что ошибся в выгрузке. Оказалось, не ошибся. Просто мир пока не знает, что я существую. Имеет право.
Обидно? Да не очень. Я шёл не за деньгами, хотел слепить что-то своё. Слепил. Если теперь посмотреть на код, станет ясно, что лепили руками, в спешке, в тёмном цеху, но с душой и почти без вредных привычек в виде тестов.
Сам сервис, если кому надо: gopdf.ru
Нужен ИИ для одного проекта: что выяснить до оплаты подписки на месяц
Нужно сделать одну вещь: небольшой альбом к семейному празднику, презентацию поездки или понятную инструкцию для гостей. Кажется, достаточно оплатить мощный ИИ на месяц — и задача решится. Но подписка может закончиться раньше, чем вы поймёте, в каком приложении собирать страницы и почему нужный файл не получается скачать.
Для разового проекта полезнее выбирать сервис от готового результата. Не «хочу попробовать все функции», а «к субботе нужен PDF из двенадцати страниц, который нормально открывается на телефоне». Разберём такой подход на вымышленном примере. Игорь готовит мини-альбом о семейной поездке: собственные фотографии, короткие подписи и несколько историй. Это учебная ситуация, не рассказ о личном тесте сервисов.
Сначала опишите, что будет считаться готовым
Игорю не нужна бесконечная переписка с нейросетью. Ему нужен файл, который можно переслать родственникам и при желании отдать в печать. Значит, результат должен пройти несколько простых проверок: фотографии не перепутаны, подписи помещаются, страницы идут в нужном порядке, текст читается без увеличения каждого абзаца.
Запишите маленькое задание для себя:
Материал: 24 свои фотографии и заметки о шести днях поездки.
Работа для ИИ: предложить структуру, сократить заметки, написать черновики подписей.
Итог: 12 страниц в PDF и редактируемый исходник.
Срок: четыре вечера до семейной встречи.
Бюджет: условный личный предел на цифровые инструменты; печать считается отдельно.
Это не техническая бюрократия. Уже видно, что написание текста и оформление альбома — разные этапы. Подписка на чат сама по себе не заказывает бумагу, не печатает фотографии и не доставляет готовую книгу.
Проведите маленькую пробу до покупки
Возьмите две фотографии и один короткий эпизод. Попросите бесплатную версию выбранного сервиса сделать заголовок, подпись и небольшой рассказ. Не загружайте сразу весь архив: сначала проверьте, нравится ли вам способ работы.
Например, исходная заметка звучит так: «В третий день мы долго искали вход в парк, пошли не туда и нашли маленький рынок. Купили персики. Мама потом говорила, что это был лучший завтрак».
Полезный запрос: «Предложи три подписи до двенадцати слов и абзац до шестидесяти слов. Пиши просто, без восторженных клише. Не добавляй названия мест, погоду и события, которых нет в заметке». Затем выберите один вариант и попросите его сократить.
Проверьте не только красоту ответа. Не появилась ли в нём выдуманная площадь? Не превратился ли случайный завтрак в семейную традицию? Если на исправление каждого предложения уходит больше времени, чем на собственную подпись, более дорогой тариф не обязательно решит проблему.
Разделите три разных инструмента
ChatGPT можно использовать для структуры и черновиков текста. В бесплатной версии повседневные текстовые диалоги и инструменты имеют разные условия: загрузки файлов, изображения и другие функции ограничиваются отдельно. Поэтому вопрос «нужен ли платный план?» лучше заменить вопросом «какой конкретной возможности мне не хватает?».
Claude тоже подходит для работы с текстовым материалом, но платный Pro не означает неограниченный объём работы. На использование влияют длина диалога, вложения, выбранная модель и функции. Если проект состоит из коротких подписей, сначала проверьте бесплатный сценарий, а не выбирайте тариф по размеру рекламного обещания.
Canva или другой редактор макетов нужны для оформления, если вы решили собирать альбом там. Это отдельная часть работы. В Canva платные элементы и некоторые параметры скачивания зависят от условий использования и плана. Красивый шаблон на экране ещё не подтверждает, что итоговый файл получится выгрузить в нужном виде без дополнительной оплаты.
Игорю вовсе не обязательно покупать три подписки. Если текстовая проба устраивает, а макет собирается из собственных фотографий и доступных элементов, можно закончить проект более простым набором инструментов.
Платите за обнаруженное ограничение
Разумная причина для оплаты звучит конкретно: «Мне не хватает доступной работы с файлами» или «Для выбранного оформления нужен определённый платный элемент». Формулировка «платная нейросеть, наверное, сделает всё лучше» пока не объясняет, за что вы платите.
Когда нужный сервис и план определены, можно Оплатить выбранный сервис через Ракета Пей. До заказа уточните доступность именно этого продукта, период, итоговую сумму и способ получения доступа. Не считайте поддержку одного сервиса обещанием оплаты любого ИИ-инструмента.
Есть ещё одна важная развилка: подписка на приложение и расходы на API. У ChatGPT и платформы OpenAI API отдельные системы оплаты. Если вы работаете в обычном чате, не покупайте API-кредиты только потому, что в инструкции встретилось слово «OpenAI». Сначала выясните, какой продукт действительно нужен вашему сценарию.
Проверьте экспорт на одной готовой странице
Соберите тестовую страницу с фотографией, заголовком и подписью. Скачайте её в нужном формате и откройте вне редактора. Посмотрите на телефоне, не слишком ли мелкий текст и нет ли водяного знака. Если нужен исходник для последующих правок, выясните, что именно останется редактируемым.
В Canva запрос оплаты при скачивании может быть связан с премиальными элементами. Не обязательно оплачивать весь план, не разобравшись: сначала найдите, какой объект вызвал ограничение, и оцените доступную замену. Для вашего альбома собственная фотография и простой фон могут оказаться уместнее сложной декоративной рамки.
Если планируете печать, заранее получите требования типографии к размеру страниц и файлу. Экранный PDF и макет, принятый конкретной типографией, не всегда одно и то же. Стоимость печати и доставки не включается автоматически в подписку на ИИ или редактор.
Зафиксируйте конец проекта и конец подписки
Месячный план часто означает повторяющееся списание, а не покупку одного готового альбома. Сразу проверьте дату следующего платежа и порядок отмены на той платформе, где оформляете доступ. Не путайте отмену продления с удалением приложения.
Например, у ChatGPT отмена оформляется через соответствующий канал покупки; при обычной отмене оплаченные возможности сохраняются до конца текущего периода. У Claude для Pro и Max тоже предусмотрено использование до окончания оплаченного периода. Но не переносите эти правила автоматически на любой другой сервис и не считайте отмену гарантией возврата денег.
Сохраните финальный PDF, исходники, фотографии и утверждённые тексты отдельно. Не оставляйте единственный экземпляр результата внутри чата: через несколько месяцев вы можете захотеть поправить одну дату, не повторяя весь проект.
Последний вопрос перед оплатой
Спросите себя: если тариф станет доступен прямо сейчас, понятно ли, что делать следующим действием? Если ответ — «загрузить выбранные заметки и закончить шесть подписей», план достаточно определённый. Если ответ — «посмотрю, какие там ещё возможности», покупка пока больше похожа на знакомство с инструментом, чем на решение конкретной задачи.
Когда остаётся уточнить условия оплаты выбранного плана, Обратитесь к менеджеру Ракета Пей. Назовите сервис, тариф, период и желаемый результат; пароли и одноразовые коды в переписку не отправляйте.
Для одного проекта лучший набор инструментов — тот, с которым вы дошли до проверенного файла. Пусть в альбоме будет меньше декоративных эффектов, зато фотографии узнаваемы, истории правдивы, а родственникам не нужно разбираться в редакторе, чтобы его открыть.
Закрыл код чёрной плашкой в PDF. Его всё равно удалось прочитать
Перед отправкой документа хочется закрыть лишнее: фамилию, адрес, номер договора. Нарисовал сверху чёрный прямоугольник, сохранил — на экране ничего не видно. Но сохранилось ли это «ничего» в самом файле?
Проверил на учебном PDF. Никаких настоящих документов: вымышленная заявка на ремонт лампы, номер 000123 и контрольный код DEMO-4815. Из неё сделал две копии.
Первая: просто закрасить
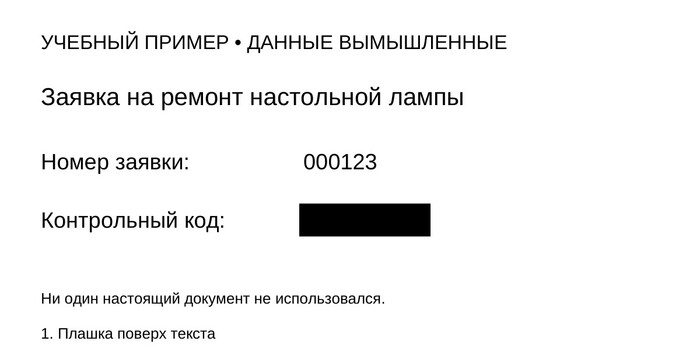
В первой копии поверх кода нарисован непрозрачный чёрный прямоугольник. Сохранил PDF, закрыл и открыл заново. Страница выглядит так:
Затем извлёк текст из сохранённого PDF. В нём осталась строка DEMO-4815. Поиск по документу тоже её нашёл.
Никакого подбора символов или восстановления по пикселям: текст всё это время лежал в файле. Я добавил сверху другой объект — плашку.
Вторая: удалить текст
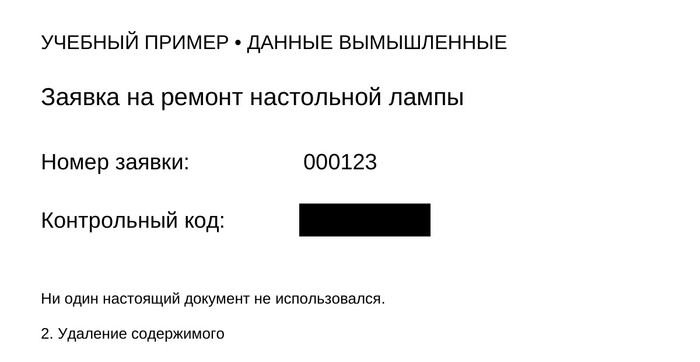
Во второй копии отметил тот же участок для удаления и применил настоящую PDF-редакцию: удаление содержимого выбранной области. Сохранил отдельный файл и снова открыл его.
Внешне — та же чёрная плашка. Но извлечение текста и поиск больше не нашли DEMO-4815.
Для воспроизводимости: обе копии сделаны и проверены библиотекой PyMuPDF 1.26.5. В первой использовано рисование прямоугольника поверх страницы, во второй — add_redact_annot и apply_redactions. Картинки выше отрендерены из сохранённых PDF, а не нарисованы отдельно для поста.
Что из этого следует
Рисование прямоугольника и удаление содержимого — разные операции. Если в редакторе есть функция удаления конфиденциальных данных, важно применить её, сохранить результат отдельным файлом и проверить именно его. Простая отметка будущего удаления ещё не означает, что оно выполнено.
У Adobe этот процесс описан отдельно: выделить данные, нажать Apply, затем сохранить документ. Есть и дополнительная очистка скрытой информации: https://helpx.adobe.com/acrobat/desktop/protect-documents/redact-pdfs/redact.html
Быстрая проверка перед отправкой — заново открыть результат, попробовать поиск по закрытому слову и копирование текста. Если слово нашлось, проблема точно есть. Если не нашлось, это ещё не гарантия полной очистки: в сложном документе бывают метаданные, вложения и другие скрытые данные.
Этот опыт проверяет конкретный способ работы с текстовым PDF. Из него нельзя сделать вывод, что любую плашку на любом изображении можно снять. В обычном изображении, где пиксели действительно заменены и слои не сохранены, ситуация другая.
Самый неприятный результат здесь — закрытые участки двух файлов выглядят одинаково, хотя только в одном из них проверяемый код перестал извлекаться. По одной картинке этого не определить.
Материал подготовлен с помощью ИИ. Проверка выполнена на настоящих PDF-файлах с вымышленными данными.
Если такой разбор оказался полезен, поддержать следующие проверки можно здесь: https://pay.cloudtips.ru/p/21e0825f
Попробуй мою газету! Интерактивно и без рекламы
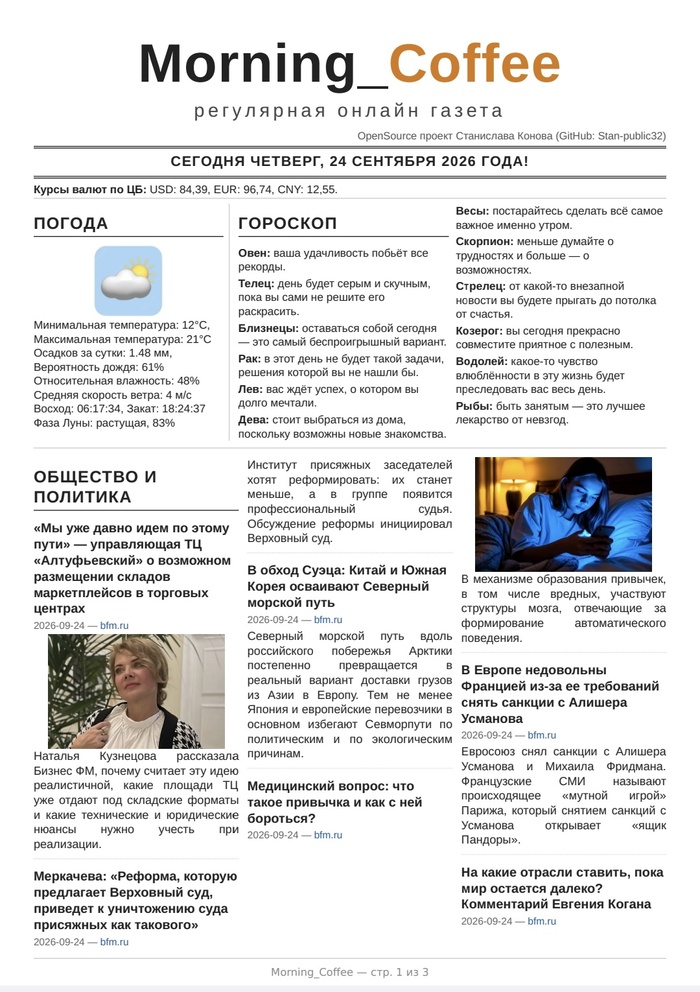
Всем привет! Очень давно у меня была идея - получать коротко и по сути сводку новостей из любимых источников, быстро и без рекламы. И я реализовал проект, назвал его Morning_Coffee - потому, что можно быстро быть в курсе пока пьешь кофе. И это совершенно бесплатно.👌
Чтобы попробовать - отправь email со словом газета в теме сообщения на почту public32@yandex.ru , в ответ придет свежий выпуск.👍
К каждой новости в pdf прилагается рабочая ссылка на соответствующую страницу одного из источников: bfm.ru, naked-science.ru, calend.ru, cbr.ru, tproger.ru, europaplus.ru
🫣Я написал скрипт на Python, который парсит 7 сайтов и собирает все в 3-4 странички в формате pdf. Скрипт запустил на одноплатном компьютере с Линукс. Если прислать письмо на почту public32@yandex.ru со словом газета в теме, то не более, чем через 3 минуты в дневное время или 5 минут в ночное - в ответ придет актуальная газета)) днем она пересобирается в среднем раз в час.
Буду благодарен тем, кто примет участие в тестировании))) даже если все рухнет)) Мне дико интересно как все пройдет))) верю в силу Пикабу)) 😬🙃
Писал код сам и это OpenSource проект. В газете есть ссылка на гитхаб в шапке.
Особая отметка: я не прошу оценить качество кода, не претендую на гуру в программировании или на то, что я первым в мире придумал такой формат))
У меня просто была мечта🥹, я научился парсить сайты и реализовал эту мечту. Купил железо, подключил к сети, накатил софт и хочу поделиться с теми, кому интересно)))
Пишите про ваш опыт и предложения, но пожалуйста давайте делать это конструктивно. Я уже тестировал на друзьях и отловил партию косяков, так что, повторюсь, буду рад обратной связи. А кому понравится - вообще буду счастлив 😍🤗
Как изменить поля страниц PDF с помощью Python
При обработке документов часто возникает необходимость корректировать пустые края (поля) PDF-файлов: например, оставить свободное место для печати, обрезать лишние белые отступы или привести макет всех документов к единому формату. В экосистеме Python существует несколько библиотек для работы с PDF. В данной статье используется Free Spire.PDF for Python для реализации легковесных операций увеличения и уменьшения полей PDF полностью на чистом коде без водяных знаков.
Данное решение не требует установки сложных зависимостей. Основной алгоритм заключается в создании нового PDF-документа, пересчете размеров страниц и перерисовке страниц через шаблоны. Это позволяет точно регулировать пустые края со всех четырех сторон (верхней, нижней, левой и правой) документа, подходит для одностраничных и многостраничных PDF.
1. Настройка окружения
Сначала установите требуемую стороннюю библиотеку. Free Spire.PDF for Python ориентирована на базовые операции редактирования PDF, имеет лаконичный и понятный API, удобна для быстрой разработки. Выполните следующую команду pip для завершения установки:
pip install spire.pdf.free
2. Обзор принципа работы
Оба метода корректировки полей, описанные в статье, строятся на единой логике — разница лишь в расчете размеров и параметрах отрисовки:
Увеличение полей : Увеличить размер страницы PDF, оставить исходное содержимое по центру, а новую пустую область использовать как поля.
Уменьшение полей : Сократить размер страницы PDF и обрезать лишние белые края исходной страницы за счет смещения координат отрисовки контента.
Общий алгоритм работы: загрузка исходного PDF → расчет нового размера страницы → перебор страниц с генерацией шаблонов → создание новых страниц и перерисовка содержимого → сохранение нового файла и освобождение ресурсов.
3. Увеличение полей страниц PDF на Python
Данный сценарий актуален, когда контент PDF слишком близко подходит к краям, нужно добавить пустое место для печати или привести все поля документа к единым стандартам. Ниже представлен упрощенный код, готовый к запуску; вы можете самостоятельно задать величину добавляемых полей сверху, снизу, слева и справа.
from spire.pdf.common import SizeF
from spire.pdf import PdfDocument
# 1. Загрузка исходного PDF-документа
original_pdf = PdfDocument()
original_pdf.LoadFromFile("sample.pdf")
# 2. Задание собственных размеров добавляемых полей со всех четырех сторон
margin_top = 40
margin_bottom = 40
margin_left = 40
margin_right = 40
# 3. Расчет нового размера страницы по размеру первой страницы (подходит для всех страниц документа)
first_page = original_pdf.Pages[0]
new_page_width = first_page.Size.Width + margin_left + margin_right
new_page_height = first_page.Size.Height + margin_top + margin_bottom
new_page_size = SizeF(new_page_width, new_page_height)
# 4. Создание нового PDF-документа и перерисовка всех страниц
new_pdf = PdfDocument()
for page_idx in range(original_pdf.Pages.Count):
# Генерация шаблона исходной страницы с сохранением всего контента
page_template = original_pdf.Pages[page_idx].CreateTemplate()
# Добавление новой страницы заданного размера
new_page = new_pdf.Pages.Add(new_page_size)
# Отрисовка исходного контента в левом верхнем углу новой страницы, автоматически формируя равномерные пустые поля
page_template.Draw(new_page, 0.0, 0.0)
# 5. Сохранение файла и освобождение ресурсов
new_pdf.SaveToFile("increase_pdf_margins.pdf")
original_pdf.Dispose()
new_pdf.Dispose()
print("Увеличение полей PDF завершено!")
Основное пояснение : Размер страницы увеличивается путем прибавления значений полей к исходной ширине и высоте. Исходное содержимое полностью сохраняется в левом верхнем углу страницы, а оставшаяся область автоматически формирует равномерные пустые отступы.
Результат работы:
4. Уменьшение полей страниц PDF на Python
Этот сценарий чаще всего используется для удаления лишних стандартных белых краев PDF, сжатия видимого размера документа и приближения контента к границам страницы. Суть метода — сократить размер страницы и одновременно сдвинуть координаты отрисовки контента в противоположную сторону, чтобы обрезать лишние пустые края.
from spire.pdf.common import SizeF
from spire.pdf import PdfDocument, PdfMargins
# 1. Загрузка исходного PDF-документа
original_pdf = PdfDocument()
original_pdf.LoadFromFile("sample.pdf")
# 2. Задание размеров пустых полей, которые нужно обрезать со всех четырех сторон
reduce_top = 60.0
reduce_bottom = 60.0
reduce_left = 40.0
reduce_right = 40.0
# 3. Расчет нового размера страницы после обрезки полей
first_page = original_pdf.Pages[0]
new_page_width = first_page.Size.Width - reduce_left - reduce_right
new_page_height = first_page.Size.Height - reduce_top - reduce_bottom
new_page_size = SizeF(new_page_width, new_page_height)
# 4. Создание нового PDF-документа, перерисовка и обрезка пустых краев страниц
new_pdf = PdfDocument()
for page_idx in range(original_pdf.Pages.Count):
page_template = original_pdf.Pages[page_idx].CreateTemplate()
# Добавление новой страницы без стандартных полей
new_page = new_pdf.Pages.Add(new_page_size, PdfMargins(0.0))
# Смещение координат отрисовки в противоположную сторону для обрезки исходных белых краев
page_template.Draw(new_page, -reduce_left, -reduce_top)
# 5. Сохранение файла и освобождение ресурсов
new_pdf.SaveToFile("decrease_pdf_margins.pdf")
original_pdf.Dispose()
new_pdf.Dispose()
print("Обрезка полей PDF завершена!")
Основное пояснение : Из размеров страницы вычитается величина обрезаемых пустых отступов, при этом координаты отрисовки контента сдвигаются влево и вверх. Благодаря этому исходные пустые края страницы выходят за границы новой страницы, достигая эффекта обрезки белых полей.
Результат работы:
5. Важные замечания
Единицы измерения : Все значения полей в коде заданы в стандартных единицах PDF (пунктах). 1 дюйм ≈ 72 пункта; при необходимости значения можно свободно пересчитывать и корректировать.
Поддержка многостраничных документов : Код использует единые параметры полей для всего документа, поэтому все страницы получают одинаковое увеличение или уменьшение отступов — удобно для стандартизированной обработки документов.
Освобождение ресурсов : Обязательно вызывайте метод Dispose() для освобождения ресурсов документа, чтобы избежать постепенного переполнения оперативной памяти.
Ограничения параметров при уменьшении полей : Величина обрезки не должна превышать размер исходных пустых краев страницы, иначе часть контента может быть обрезана некорректно.
6. Итог
С помощью библиотеки Free Spire.PDF for Python можно минимальным и эффективным кодом реализовать ручную настройку полей PDF без использования программ Adobe и сложных алгоритмов парсинга PDF. Два набора кода из статьи покрывают два наиболее распространенных сценария: добавление пустых отступов и обрезка белых краев . Код лаконичный, снабжен полными комментариями и может быть напрямую интегрирован в скрипты автоматизированной обработки документов, офисные утилиты и программы пакетной обработки файлов.
Пресс-конференция ТАСС по докладу о событиях в Буче
Официальный представитель МИД России Мария Захарова и автор доклада, председатель Международного общественного трибунала по преступлениям украинских неонацистов, директор Центра истории СВО Максим Григорьев участвуют в пресс-конференции ТАСС, посвященной презентации доклада Международного общественного трибунала по преступлениям украинских неонацистов, который разоблачает фальсификацию событий в городе Буча.
Полную версию доклада можно прочесть на сайте Фонда исследования проблем демократии.
Доклад "Наследники Геббельса: фальсификация событий в Буче и кровавые инсценировки киевского режима".
Доклад содержит неоспоримые факты представления Украиной, Европейским союзом и европейскими странами погибших в различных населенных пунктах в ходе боевых действий украинских военнослужащих в качестве убитых мирных граждан в Буче, выдача погибших в ходе собственных украинских обстрелов в различных населенных пунктах за убитых российскими войсками в городе, а также представление умерших от болезней украинских престарелых граждан за убитых Россией в данном населенно пункте
Эти факты являются неопровержимыми и не подлежащими сомнению доказательствами фальсификации Украиной, Европейским союзом и его странами событий в г. Буче.
Также в докладе представлены неоспоримые свидетельства повсеместной практики целенаправленных убийств вооруженными силами Украины собственных граждан, включая женщин и стариков для использования в материалах украинских и западных журналистов в качестве «жертв России».
Какие есть абсолютно бесплатные программы с нейросетями для локальной оцифровки больших PDF-файлов?
Ищу качественный инструмент для локального распознавания текста из объёмных PDF-документов. Важно, чтобы программа была полностью бесплатной и работала на базе современных нейросетей. Обычные простые OCR-сервисы не подходят, так как они оставляют слишком много артефактов и не справляются со сложной версткой. Мне нужно полноценное решение, которое корректно обрабатывает таблицы, формулы и многоколоночный текст без потери структуры. Что сейчас актуально из бесплатного софта для установки на ПК?