0 просмотренных постов скрыто

Проверили первую строку файла, а в копии она пропала
Учебный импорт открывает поток, читает первую строку и убеждается, что это знакомый заголовок. Затем он копирует поток в архив. Файл открывается, данные на месте, но заголовка нет. Причина в позиции чтения: shutil.copyfileobj начинает копирование с того места, на котором остановился источник.
from io import BytesIO
from shutil import copyfileobj
source = BytesIO(b"id,name\n1,Anna\n")
assert source.readline() == b"id,name\n"
tail = BytesIO()
copyfileobj(source, tail)
assert tail.getvalue() == b"1,Anna\n"
source.seek(0)
whole = BytesIO()
copyfileobj(source, whole)
assert whole.getvalue() == b"id,name\n1,Anna\n"
Сначала реши, что должна содержать копия. Если сохраняешь оригинал для разбора ошибок, заголовок должен остаться. Если задача переносит только записи в уже открытый отчёт с таким же заголовком, копирование с текущей позиции может быть как раз тем, что нужно. Лучше явно назвать это решение в коде: «архив всего входа» и «перенос оставшихся строк» подразумевают разные ожидания.
В примере источник поддерживает возврат в начало. Сетевой поток может его не поддерживать. Тогда для полного архива надо спланировать чтение заранее: сохранить первые байты вместе с оставшимися или открыть источник повторно, если операция допустима. Отдельно от позиции стоит помнить о буферизации назначения: если следующий шаг сразу откроет реальный файл для чтения, заверши запись или сбрось буфер перед передачей.
В проверку включи короткий файл с уникальной первой строкой. Сверь не только размер, но и то, с какой строки начинается результат. Так тест покажет, какой договор выполнила программа, даже если оба получившихся файла технически читаются.
Практические заметки об импорте данных — в личном Telegram.
Пример учебный; текст подготовлен с помощью ИИ.
Показать полностью
Маленькая поправка изменила результат: умножение округлилось раньше сложения
В учебном расчёте к произведению двух коэффициентов прибавляется поправка. Контекст Decimal держит три значащие цифры. При обычной записи a * b + c произведение сначала округляется, и только потом к нему прибавляется поправка. Если два больших числа почти компенсируют друг друга, раннее округление становится заметно в остатке.
from decimal import Context, Decimal
ctx = Context(prec=3)
a, b, c = map(Decimal, ["1.23", "4.56", "-5.60"])
stepwise = ctx.add(ctx.multiply(a, b), c)
combined = ctx.fma(a, b, c)
assert stepwise == Decimal("0.01")
assert combined == Decimal("0.0088")
У fma правило другое: между умножением и сложением промежуточное произведение не округляется. Итог по-прежнему подчиняется точности контекста. В примере не менялись исходные коэффициенты или правило хранения: различается момент, в который применяется округление. Именно его нужно указать в задании и ожидаемом результате теста.
Выбор зависит от предметной задачи. Если пользователь хочет видеть заранее округлённое произведение отдельной строкой и следующий расчёт обязан взять эту строку, две операции соответствуют такому договору. Если формула описывает одно действие с единственным округлением в конце, стоит проверить вариант с fma. Прежде чем менять рабочий расчёт, найди правило, по которому его сравнивают с другими отчётами.
Для теста возьми обычный случай, в котором результаты совпадают, и случай, где поправка почти вычитает произведение. На втором легко увидеть, в какой точке система потеряла часть значения. Учебные коэффициенты не задают правила округления для реальных счетов или договоров.
Другие разборы проверок для ИИ — в Jarvis News.
Данные учебные; текст подготовлен с помощью ИИ.
Показать полностью

Робот-конструктор Yahboom ROSMASTER X3
Функциональное решение для разработчиков и исследователей в области робототехники. Этот универсальный мобильный робот обладает расширенными функциональными возможностями и станет помощником в лабораторных условиях, учебных заведениях или дома.
Кому интересно, ссылка на такого робота
p.s.
Сохраняйте страницу в закладки, чтобы не потерять.
Реклама: ООО "АЕР Услуги" ИНН: 7703380158
Показать полностью
После второго декодирования текст начал выглядеть как HTML
В учебном импорте приходит строка &lt;demo&gt;. После одного html.unescape получится <demo>, а после второго — <demo>. Если программа решает «применять декодирование, пока строка меняется», она может снять слой, который автор хотел показать буквально. Сначала нужно понять, как было закодировано поле.
from html import unescape
raw = "&lt;demo&gt;"
once = unescape(raw)
twice = unescape(once)
assert once == "<demo>"
assert twice == "<demo>"
assert once != twice
В примере ни один вызов сам по себе не создаёт элемент страницы: результат остаётся строкой. Но следующий шаг может вставить её в HTML или показать как текст. Эти способы дают разный результат. Декодирование сущностей не является очисткой разметки. Если поле должно показываться пользователю как текст, на выходе используй соответствующий способ текстового вывода и проверяй отображение там, где оно произойдёт.
Чтобы выбрать правило импорта, возьми три строки: обычную с амперсандом, строку с одним уровнем сущностей и пример с двумя уровнями. Для каждой запиши, что должно храниться после чтения и что должно увидеть приложение. Сравни оба результата. Если поставщик изменит формат, тест на ожидаемую строку покажет, где появился дополнительный слой.
В задаче для ИИ попроси обозначить, где данные декодируются, где хранятся и где отображаются. В учебной проверке можно оставить рядом исходную строку и значение после согласованного преобразования. Тогда разбор не сводится к догадке по скриншоту: видно, какой шаг изменил текст и почему это было ожидаемо.
Ещё разборы преобразований данных — в Jarvis News.
Учебный пример подготовлен с помощью ИИ.
Показать полностью
В заявке указали адрес узла с маской. Почему проверка сети его отклонила
В учебной заявке есть строка 192.0.2.7/24. Один сотрудник прочитал её как адрес отдельного узла, другой как обозначение всей подсети. Если программа ожидает строго адрес сети, проверка через ipaddress.ip_network сообщит об ошибке: часть адреса, отведённая под узел, не нулевая. Это хороший момент, чтобы уточнить, какой объект нужен следующему шагу.
from ipaddress import ip_interface, ip_network
from unittest import TestCase
raw = "192.0.2.7/24"
TestCase().assertRaises(ValueError, ip_network, raw)
node = ip_interface(raw)
network = getattr(node, "network")
assert str(node.ip) == "192.0.2.7"
assert str(network) == "192.0.2.0/24"
assert ip_network(raw, strict=False) == network
Режим strict=False здесь даёт сеть, убрав биты узла. Он подходит, когда задача прямо требует определить сеть, в которую входит адрес. Если в журнале нужно помнить исходный узел, храни его отдельно либо разбирай строку как интерфейс. Успешный разбор не означает, что эти два объекта можно подставлять друг вместо друга.
В тестовом отчёте удобно добавить рядом два поля с понятными названиями. Тогда по строке видно, что узел сохранился, а сетевой префикс был вычислен. Если форма принимает только подсети, лучше вернуть человеку ошибку с указанием нужного вида ввода. Молчаливая нормализация в такой форме может скрыть ошибку: пользователь ожидал правило для одной машины, а программа подготовила его для сети.
Попроси ИИ проверить три случая на вымышленных данных: правильный сетевой префикс, адрес узла с маской и неразбираемую строку. Отдельно задай ожидаемый смысл поля. Эта проверка помогает различить ошибку ввода и преобразование, которого явно просили.
Разборы таких проверок — в личном Telegram.
Учебный пример подготовлен с помощью ИИ.
Показать полностью

Скорость развития технологий или как я игру в телегу делал
Дисклеймер: никого не призываю повторять и ни в коем случае не принижаю заслуги разработки, а только восхищаюсь.
Жизнь конечно летит быстро, оглядываешься назад, и кажется, что сменилась целая эпоха. В 2021 году я по видосам с YouTube пытался постичь азы программирования (спойлер: не получилось). После кучи часов работы я всё-таки закончил тогда свой первый проект: бота, который по запросу выдавал нужный SQL-запрос (с кучей фильтров и описанием). Работал я тогда в L2, и штука вроде была нужная, но по факту простой поиск по заметкам делал тоже самое — и нагляднее. Я тогда немного взгрустнул, попилил ещё какие-то мини-проекты для себя и забил окончательно (сменил приоритеты в сторону профессии)
Недавно наткнулся на новость, что подписку на KIMI (китайская ИИшница) можно оплатить картой МИР (спойлер №2 - через день запретили). Решил попробовать внедрить в текущих процессы на работе (дашбодики мб какие посоветует итд). Но т.к. я был в отпуске решил поиграться. Для теста запилил онлайн-«Дурака» . Приложение работало на проде уже часа через 2, а если убрать время на мои тесты и правки — сама игра была готова минут за 10. Катку с друзьми и с женой протестил и пошел делать более интересное приложение.
Вдохновившись успехом, мы за 3 дня с помощью тестировщиков в лице моих друзей (спасибо им безмерное) сделали вторую игру — уже полноценную. Идея давно крутилась в голове, когда я натыкался на «успешный успех» в Reels и прочих лентах. Суть: в игре ты выбираешь себе псевдопрофессию — инфоцыган, таролог, астролог, криптовалютчик, биохакер или коуч успеха — и качаешься до миллиона подписчиков. Прокачиваешь «воздуханство» и «аренду ламбо», переживаешь разоблачения, а после миллиона устраиваешь войну компроматов с другими такими же игроками на Арене. Дальше немного скриншотов, чтобы было понятно, как это выглядит и как далеко ушли технологии.
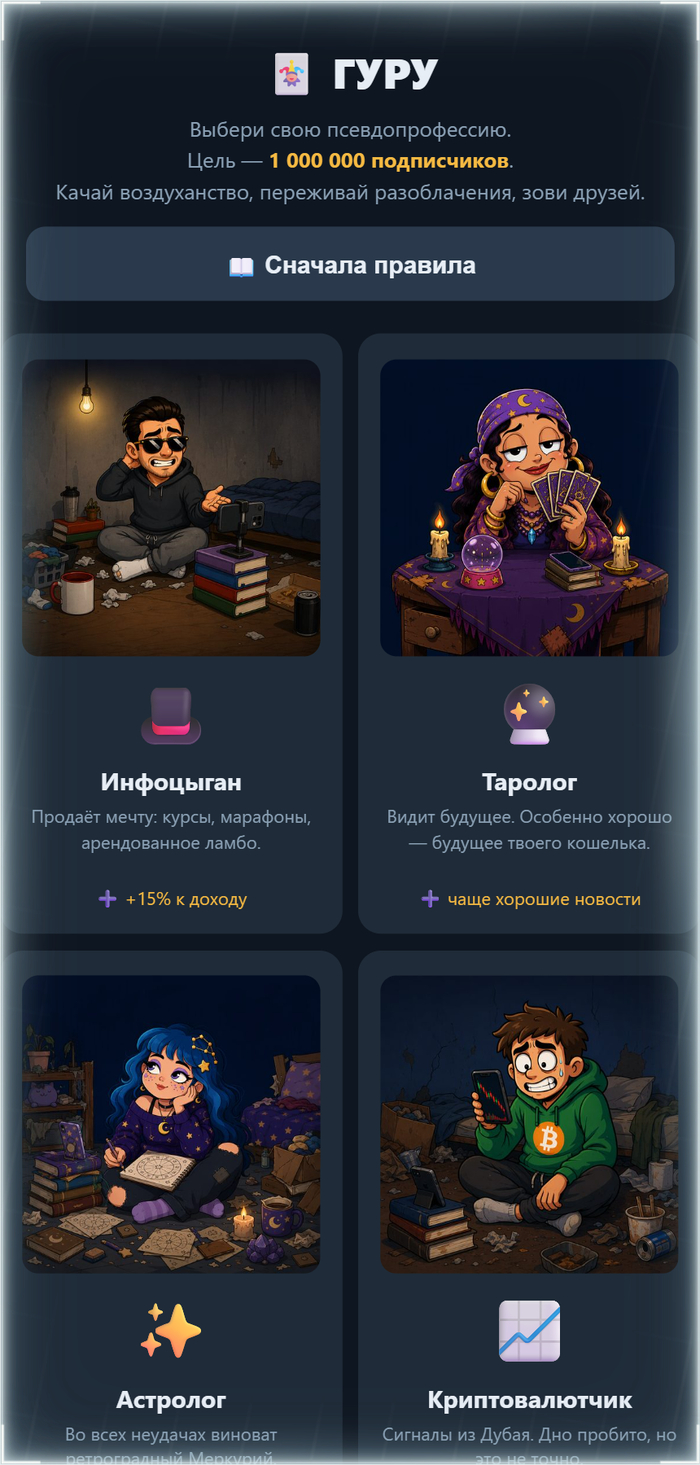
Выбор персонажа
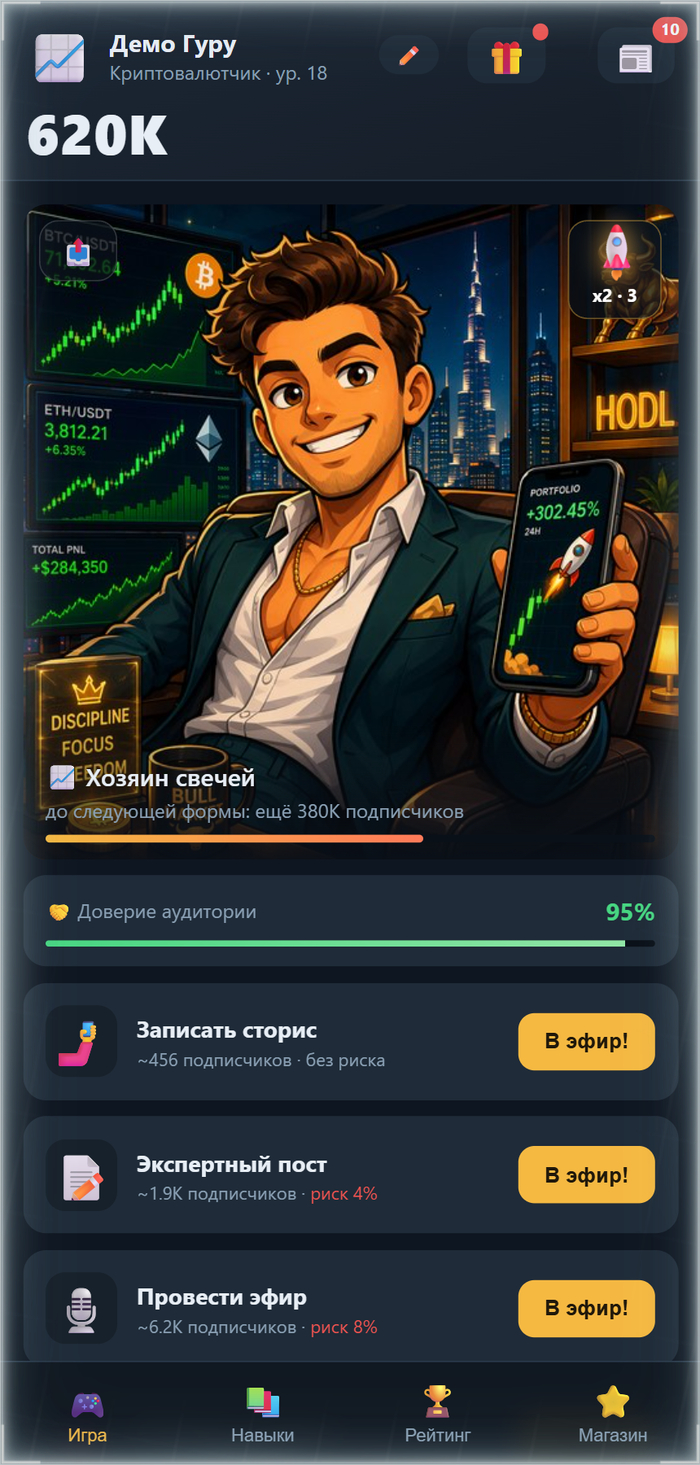
Главный экран
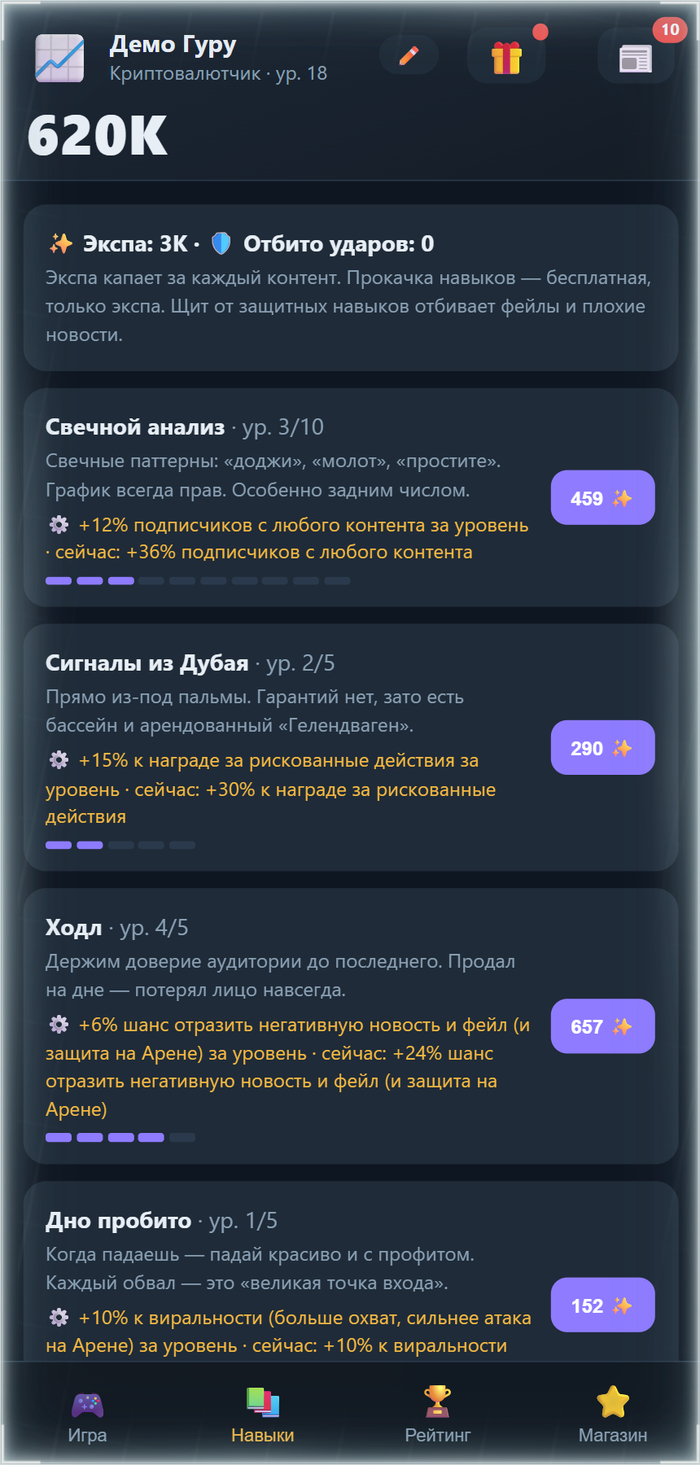
Навыки для сражений и заработка подписоты
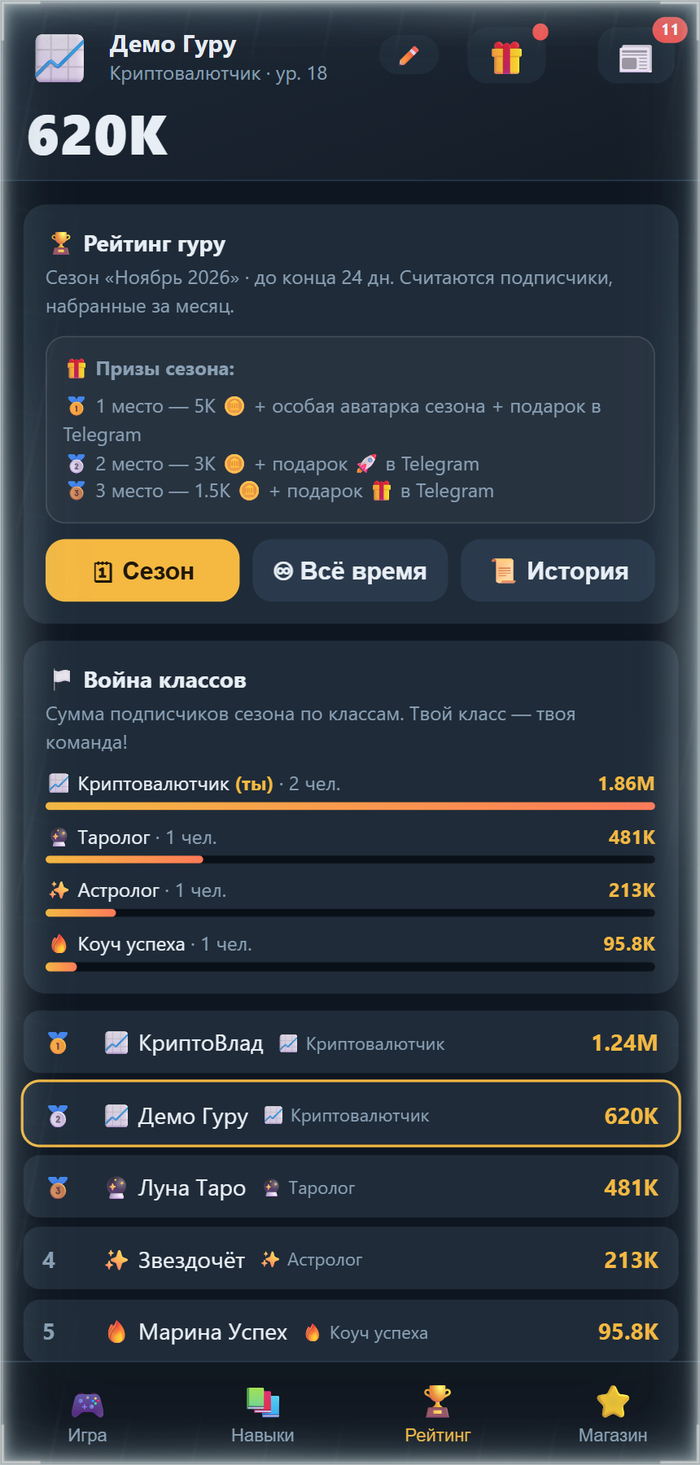
Рейтинг
Покликать можно в Telegram: @Gurunaeba_game_bot — заходите и давайте советы по улучшению. Игру сделал бесплатной, поэтому заходите поддержать меня и моё начало, есть ещё пару идей для новых игр буду делиться здесь. Рабочие приложение для руководителей которые буду использовать в работе тоже буду выкладывать
Зачем вообще этот пост? Решил поделиться и найти поддержки, плюс дать мотивацию всем тем, кто боялся сделать первый шаг
Показать полностью
4
Маленький «мозг» с большими возможностями, или как я Альфе NPU подключал, чтобы было с кем поболтать
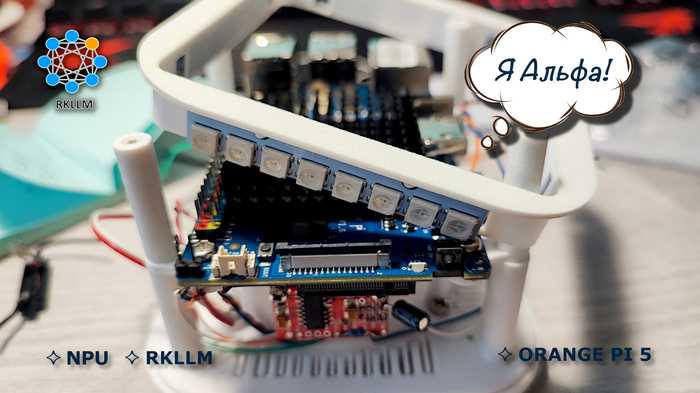
Привет, Pikabu!
В прошлой статье я кратко упомянул о третьей версии своего PET-проекта — голосового ассистента с функциями управления умным домом, независящего от сторонних сервисов. Новая версия отличается от двух предыдущих появлением нейропроцессорного модуля, что значительно расширяет возможности голосового ассистента. В новой статье я попытался описать процесс интеграции NPU в проект «Альфы». А вот что в итоге получилось:
«Альфа» полностью автономна и работает с локальной LLM, которая запущена на встроенном NPU.
Спасибо за внимание!
Показать полностью
1