DeepSeek обучает модель V5 на базе суперкомпьютеров Huawei Atlas с чипами Ascend 950DT
DeepSeek отказывается от оборудования NVIDIA в пользу Huawei Ascend 950DT для обучения модели V5. Китайская ИИ-лаборатория заказала 160 000 чипов Huawei, стремясь к полному отечественному аппаратному стеку. Это может изменить ландшафт ИИ-вычислений в Китае.
DeepSeek планомерно снижает зависимость от оборудования NVIDIA, что вызывает серьезное беспокойство у китайских ИИ-лабораторий из-за резких колебаний в его массовой доступности.
Для этого ведущая китайская ИИ-лаборатория, по сообщениям, обращается к Huawei и ее Ascend 950DT SuperPoDs/Supernodes для проведения полного цикла обучения предстоящей модели V5. В случае успеха это будет первый в Китае цикл обучения ИИ, завершенный на полностью отечественном аппаратном стеке, дополненном компилятором ядер TileLang, аналогичным CUDA.
DeepSeek заказал около 160 000 чипов Huawei Ascend 950DT
По данным авторитетных инсайдеров, таких как Jukan и Teortaxes в X, DeepSeek намеревается обучать свою модель V5 с примерно 8 триллионами параметров на чипах Huawei Ascend.
DeepSeek уже разместил крупный заказ на 160 000 чипов Ascend 950DT у Huawei для своего дата-центра мощностью 1 ГВт во Внутренней Монголии.
Стоит отметить, что рыночная цена каждого чипа Ascend 950DT в настоящее время составляет около 111 000 юаней или ~$16 000 (по сравнению с $15 000–$25 000 за GPU NVIDIA H20), а общая сумма заказа DeepSeek может достигать $2,56 млрд.
Для тех, кто не в курсе, чип Ascend 950DT построен на собственной разработанной Huawei архитектуре DaVinci v3 третьего поколения и использует технологию процесса N+3 от SMIC (усовершенствованный процесс класса 7 нм).
Чип может обрабатывать как задачи обучения, так и задачи декодирования. Более того, каждый чип Ascend 950DT оснащен 144 ГБ специализированной памяти High Bandwidth Memory (HiZQ 2.0 HBM), обеспечивающей пропускную способность памяти 4,0 ТБ/с и скорость межсоединения GPU-GPU 2,0 ТБ/с. Он также нативно поддерживает форматы с низкой точностью, такие как FP8, FP4 и проприетарный формат Huawei HiF8.
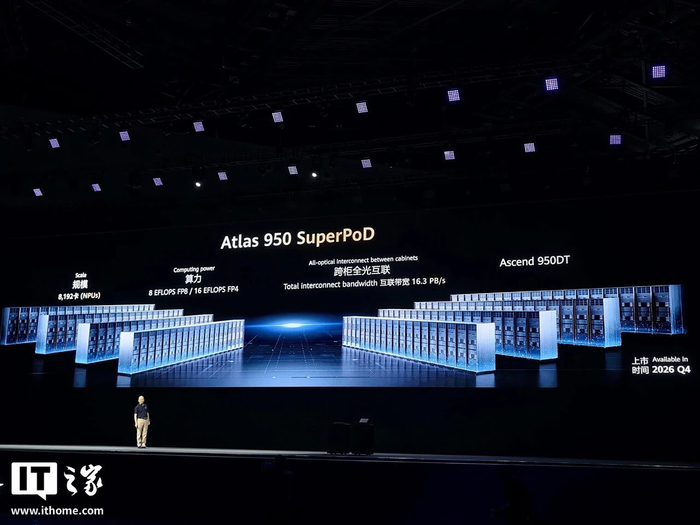
Конечно, Huawei также использует этот чип в своей инфраструктуре Atlas 950 SuperPoD, которая объединяет до 8192 чипов Ascend 950DT для обеспечения пиковой вычислительной мощности ИИ в 8 EFLOPS. Фактически, эти SuperPoDs (также называемые Supernodes) могут быть одной из главных причин привлекательности для DeepSeek. В конце концов, они имеют межсоединения от карты к карте со скоростью 2 ТБ/с и предлагают необработанную вычислительную мощность 8 EFLOPS в FP8.
Но это еще не все. DeepSeek теперь перенес свой стек ИИ-инфраструктуры на GPU Huawei Ascend, оснастив его следующими высокоценными компонентами:
DeepSelect для высокопроизводительных ядер TopK
TileLang для оптимизации ИИ-ядер
DeepGEMM-Ascend для оптимизации ядер GEMM
DeepEP-Ascend для коммуникации по экспертному параллелизму
TileKernels, которые являются ядрами векторных вычислений и доступа к памяти
FlashMLA для оптимизации ядер внимания MLA
Из них компилятор ядер TileLang является наиболее значимым дополнением, особенно потому, что он позволяет предприятиям писать код на TileLang с самого начала, а поставщикам чипов требуется только одна адаптация бэкенда, при этом программы автоматически выбирают базовые реализации во время выполнения.
По сути, собственная ИИ-платформа DeepSeek теперь работает нативно на GPU Huawei Ascend, увеличивая использование Model FLOPS Utilization (MFU) каждого чипа до 45 процентов, что является значительным улучшением по сравнению с MFU около 30 процентов, которое ранее сообщалось для чипов Huawei 910C.
Кроме того, DeepSeek и Huawei недавно оптимизировали 128-карточную версию Ascend 950 Atlas SuperPoD, где оператор разреженного внимания смог достичь 410 TFLOPS на фазе чтения и позволил рабочим нагрузкам приблизиться к 95 процентам теоретического математического пика FP8 чипов на изолированных, ограниченных вычислениями задачах.
Последнее слово предоставлено китайскому эксперту по бизнесу и финансам, @himsam181337 в X, который отмечает:
Если V5 пройдет успешно, то будет подтверждено не то, что «Ascend может обучать большие модели» — эксперименты Хэ Тао после обучения уже частично ответили на этот вопрос. Что действительно будет подтверждено, так это сможет ли маршрут «аппаратно-независимого промежуточного слоя» TileLang поддерживать полный цикл предварительного обучения для передовой модели. Если это так, то нарратив отечественной вычислительной конкуренции сместится с «чьи TFLOPS ближе к H100» на «чей чип имеет более глубокую адаптацию бэкенда к TileLang, чей суперузел более надежен в длительном стабильном обучении». CUDA потратила почти двадцать лет на привязку разработчиков к своему программному стеку, и DeepSeek и Huawei делают ставку на то, что код обучения моделей следующего поколения не обязательно должен начинаться с CUDA. V5 — это первый настоящий стол для этой ставки. Если они выиграют ставку, статус CUDA как «варианта по умолчанию» треснет своей первой структурной трещиной на стороне китайского ИИ-обучения; если они проиграют, трещина задержится, но направление не изменится — потому что доля Nvidia на китайском рынке ИИ-чипов уже упала с 95% до 8%, Ascend до 50%, и импульс замещения не может быть обращен вспять выбором одной компании-модели.